A maleabilidade e adaptabilidade das florestas aleatórias são uma das muitas vantagens deste tipo de modelo. Da previsão do tempo à análise de risco de crédito, esse tipo de método tem muitas aplicações. E risco de crédito é o tema desse artigo.
Vagando pelo banco de dados infinito do Kaggle encontrei um banco de dados de com registros de 887 mil registros de empréstimos com dados dos mutuários e a situação do empréstimo.
Com o conjunto de dados em meu computador, iniciei a análise inicial para entender as dimensões e as variáveis.
Mas antes, preciso importar as bibliotecas necessárias e para isso gosto de usar esse método que as importa e instala automaticamente:
pkgs =
 c(“plotly”,”tidyverse”,”reshape2",”knitr”,”kableExtra”,”rgl”,”car”,
 “jtools”, “data.table”, “GGally”, “cowplot”, “janitor”,
“funModeling”, “modeldata”, “Metrics”)if(sum(as.numeric(!pkgs %in% installed.packages())) != 0){
install = pkgs[!pkgs %in% installed.packages()]
for(i in 1:length(install)) {
install.packages(install, dependencies = T)
break()}
sapply(pkgs, require, character = T)
} else {
sapply(pkgs, require, character = T)
}Com os pacotes instalados podemos fazer a importação dos dados utilizando o comando fread:
data = fread("loans.csv")Obs: eu sei que em R o correto é fazer uma atribuição utilizando <-, porém meu cérebro não aceita bem isso e sigo usando o =. Por favor não me julguem :)
Temos duas colunas de identificação nesta base, id e member_id ambas desnecessárias para nossa análise. Manterei a coluna id como identificador das linhas e removerei member_id.
data_cleaned =
   data %>%
   # column id transformed in row name
   column_to_rownames("id") %>%
   # removing column member_id
   select(everything(), -member_id)
Após a remoção destas duas colunas o dataset permanece ainda com 72 colunas. Será necessário fazer a análise de cada uma delas para determinar aquelas que são relevantes para o modelo. Observe que ao invés de trabalhar no dataset original eu criei um novo, com isso mantenho os dados originais intactos e evito novas importações. A partir deste ponto todo o trabalho será feito com o dataset data_cleaned.
Análise de variáveis categóricas
As random forests trabalham bem com variáveis categóricas, porém é importante verificar a quantidade de “categorias” presentes em cada variável para que reduzamos a amplitude das informações sem perdermos sua objetividade. Muitas categorias podem tornar a análise inviável fragmentando os resultados gerados. Lembre-se, modelos preditivos tentam prever o futuro e dar muitas opções aumenta a taxa de erro podendo inviabilizar o resultado.
Iniciaremos listando as variáveis categóricas, que nesta base de dados são todas do tipo texto.
data_cleaned %>%
   # selecting character columns becouse I
   select_if(is.character) %>%
   names() %>%
   reshape2::melt()
value
1 term
2 grade
3 sub_grade
4 emp_title
5 emp_length
6 home_ownership
7 verification_status
8 issue_d
9 loan_status
10 pymnt_plan
11 url
12 desc
13 purpose
14 title
15 zip_code
16 addr_state
17 earliest_cr_line
18 initial_list_status
19 last_pymnt_d
20 next_pymnt_d
21 last_credit_pull_d
22 application_type
23 verification_status_jointVamos primeiro falar sobre nossa variável alvo a loan_status, que indica qual a situação daquele empréstimo.
data_cleaned %>%
   tabyl(loan_status) %>%
   adorn_pct_formatting() %>%
   arrange(desc(n))
loan_status n percent
Current 601779 68.0%
Fully Paid 207723 23.5%
Charged Off 45248 5.1%
Late (31-120 days) 11591 1.3%
Issued 8460 1.0%
In Grace Period 6253 0.7%
Late (16-30 days) 2357 0.3%
Default 1219 0.1%
Does not meet the credit policy. Status:Charged Off 761 0.1%Como pode-se observar, um empréstimo pode ter vários status, dependendo do momento:
· Current: indica que o empréstimo está ativo e com pagamentos em dia
· Fully Paid: empréstimos totalmente pagos e finalizados
· Charged Off: indica que a dívida do empréstimo é incobrável.
· Late (31-120 days): empréstimo possui pagamentos com atraso entre 31 e 120 dias
· Issued: empréstimos recentemente liberados, ainda sem pagamentos emitidos ou recebidos
· In Grace Period: empréstimo possui pagamento em período de carência, ou seja, vencido entre 1 e 15 dias
· Late (16-30 days): empréstimo possui pagamentos com atraso entre 16 e 30 dias
· Default: quando o titular do empréstimo não é capaz de realizar pagamentos por um longo período (superior a 120 dias)
· Does not meet the credit policy. Status:Charged Off: solicitação do empréstimo é cancelada quando o titular possui dívidas consideradas incobráveis.
Avaliando os possíveis valores podemos separá-los em três grupos:
Bons pagadores
· Fully Paid
Maus pagadores
· In Grace Period, Late (16-30 days) e Late (31-120 days) e Default indicam potenciais atrasos em pagamento
· Charged Off indica uma dívida que não será recebida sem a necessidade de apoio jurídico
Indefinido (situação não indica se os pagamentos podem ou não atrasar:
· Current empréstimos com pagamento em dia não necessariamente indicam que serão totalmente pagos dado que pode haver atraso em parcelas futuras
· Issued: e Does not meet the credit policy. Status:Charged Off representam empréstimos que não iniciaram ou nunca serão iniciados
Como eu comentei anteriormente é importante tentarmos reduzir a quantidade de categorias sempre que possível, neste caso, podemos transformar a coluna loan_statusem uma nova coluna com 2 valores que indiquem a informação que desejamos: bons e maus pagadores. Também podemos reduzir a quantidade de dados, removendo da base de dados empréstimos que não possuem informações relevantes, neste caso aqueles com a situação considerada indefinida.
Vamos começar pela exclusão dos lançamentos que não serão utilizados no modelo.
data_cleaned =
   data_cleaned %>%
   filter(!loan_status %in% c(
      "Current",
      "Does not meet the credit policy. Status:Charged Off",
      "Issued"
   )
)
Agora vamos simplificar a nossa variável resposta:
data_cleaned =
   data_cleaned %>%
   # creates a new column with the value from good and bad borrow
   mutate(
      target = ifelse(
         loan_status == 'Fully Paid',
         'Good borrow',
         'Bad borrow')) %>%
   # select all columns minus the loan status
   select(everything(), -loan_status)
Obs: mantive os valores em inglês para seguir o padrão da base. Utilizei a função ifelse para simplificar o código, já que somente os empréstimos totalmente pagos são considerados bons.
Vamos executar novamente a verificação dos valores agora na variável target para verificarmos como ficaram distribuídos os novos valores.
data_cleaned %>%
   tabyl(target) %>%
   adorn_pct_formatting() %>%
   arrange(desc(n))
target n percent
Good borrow 207723 75.7%
Bad borrow 66668 24.3%Seguindo a análise com as demais variáveis categóricas, eu as separei em 3 grupos:
Grupo 1 — Variáveis que serão deixadas como estão
Estas variáveis não precisam de tratamento. Apenas uma observação sobre a variável addr_state, embora ela possua muitas categorias (estados americanos) entendo que ela é relevante pois pode ajudar a indicar em quais estados existe maior chance de calote na dívida.
data_cleaned %>%
   tabyl(emp_length) %>%
   adorn_pct_formatting() %>%
   arrange(desc(n))
## emp_length n percent
## 10+ years 83448 30.4%
## 2 years 25479 9.3%
## < 1 year 22738 8.3%
...data_cleaned %>%
tabyl(addr_state) %>%
adorn_pct_formatting() %>%
arrange(desc(n))## addr_state n percent
## CA 46195 16.8%
## NY 23446 8.5%
## TX 21012 7.7%
...data_cleaned %>%
tabyl(term) %>%
adorn_pct_formatting() %>%
arrange(desc(n))## term n percent
## 36 months 209857 76.5%
## 60 months 64534 23.5%data_cleaned %>%
tabyl(home_ownership) %>%
adorn_pct_formatting() %>%
arrange(desc(n))## home_ownership n percent
## MORTGAGE 134317 49.0%
## RENT 115685 42.2%
## OWN 24204 8.8%
...data_cleaned %>%
tabyl(purpose) %>%
adorn_pct_formatting() %>%
arrange(desc(n))## purpose n percent
## debt_consolidation 162080 59.1%
## credit_card 53936 19.7%
## home_improvement 16142 5.9%
...Grupo 2 — Variáveis que serão removidas
Estas variáveis trazem informações unitárias, como observações de cada empréstismo, URL com informações da solicitação, CEP do cliente e datas de aprovação.
# the zip code isn´t an option becose the state code will be used as a location info
# commented to avoid unnecessary processing
#data_cleaned %>%
#   tabyl(zip_code) %>% adorn_pct_formatting() %>% arrange(desc(n))

# month when loand was funded
# commented to avoid unnecessary processing
#data %>%
#   tabyl(issue_d) %>% adorn_pct_formatting() %>% arrange(desc(n))

# indicate of the bank verified the borrowers'
data_cleaned %>%
   tabyl(verification_status) %>%
   adorn_pct_formatting() %>%
   arrange(desc(n))
## verification_status n percent
## Verified 100925 36.8%
## Not Verified 90739 33.1%
## Source Verified 82727 30.1%# month that credit line was opened
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(earliest_cr_line) %>% adorn_pct_formatting() %>% arrange(desc(n))
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(emp_title) %>% adorn_pct_formatting() %>% arrange(desc(n))
# that variable have the same value for almost the role dataset.
data_cleaned %>%
tabyl(pymnt_plan) %>%
adorn_pct_formatting() %>%
arrange(desc(n))## pymnt_plan n percent
## n 274384 100.0%
## y 7 0.0%# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(url) %>% adorn_pct_formatting() %>% arrange(desc(n))
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(desc) %>% adorn_pct_formatting() %>% arrange(desc(n))
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(title) %>% adorn_pct_formatting() %>% arrange(desc(n))
# next payment date
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(next_pymnt_d) %>% adorn_pct_formatting() %>% arrange(desc(n))
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(last_credit_pull_d) %>% adorn_pct_formatting() %>% arrange(desc(n))
data_cleaned %>%
tabyl(application_type) %>%
adorn_pct_formatting() %>%
arrange(desc(n))## application_type n percent
## INDIVIDUAL 274385 100.0%
## JOINT 6 0.0%# last payment date
# commented to avoid unnecessary processing
#data_cleaned %>%
# tabyl(last_pymnt_d) %>% adorn_pct_formatting() %>% rrange(desc(n))Obs: mantive as variáveis com mais categorias comentadas para evitar processamento desnecessário e que o output da execução transforme este texto em uma enciclopédia.
Grupo 3 — Variáveis sem informações
Este é para mim o único problema com esta base de dados, a falta de um dicionário de dados que indique a função de cada variável e os possíveis valores que podem ser armazenados em cada uma.
Dentro da análise de variáveis categóricas 3 delas não possuem qualquer indicador do que sejam os valores armazenados ou seu objetivo e por isso tomei a decisão de removê-las da base
Embora gradee sub_grade indiquem o agrupamento dos empréstimos seus valores não são claros, não deixam claro o que significa cada um dos grupos.
data_cleaned %>%
   tabyl(grade) %>% adorn_pct_formatting() %>% arrange(desc(n))
## grade n percent
## B 79917 29.1%
## C 71584 26.1%
## D 45682 16.6%
...data_cleaned %>%
tabyl(sub_grade) %>% adorn_pct_formatting() %>% arrange(desc(n))## sub_grade n percent
## B3 18852 6.9%
## B4 17895 6.5%
## C1 16112 5.9%
...data_cleaned %>%
tabyl(initial_list_status) %>% adorn_pct_formatting() %>% arrange(desc(n))## initial_list_status n percent
## f 193471 70.5%
## w 80920 29.5%Uma vez selecionadas as variáveis que não serão utilizadas, faremos a exclusão delas:
data_cleaned =
   data_cleaned %>%
   select(
    everything(),
    # unnecessary variables
    -issue_d, -url, -pymnt_plan, -desc, -title,
    -earliest_cr_line,-verification_status,
    -emp_title, -next_pymnt_d, -last_credit_pull_d, -application_type,
    -zip_code, -last_pymnt_d,
    # variables without details
    -grade, -sub_grade, -initial_list_status)
Para finalizar a análise e preparação das variáveis qualitativas é necessário um último passo, transformando-as em variáveis do tipo factor. Para isso vamos primeiro conferir quais são as variáveis texto que precisamos converter.
data_cleaned %>%
   select_if(is.character) %>%
   names() %>%
   reshape2::melt()
## value
## 1 term
## 2 emp_length
## 3 home_ownership
## 4 purpose
## 5 addr_state
## 6 verification_status_joint
## 7 targetAgora vamos transformá-las em factor e utilizar o comando droplevels para que categorias não utilizadas sejam removidas.
data_cleaned =
   data_cleaned %>%
   mutate(across(
      .cols = c(target, emp_length, term, home_ownership, purpose, addr_state, verification_status_joint),
      .fns = as.factor)) %>%
   droplevels()
Análise de variáveis numéricas
Uma vez analisadas as variáveis categóricas faremos o mesmo processo com as variáveis numéricas.
data_cleaned %>%
   select_if(is.numeric) %>%
   names() %>%
   reshape2::melt()
## value
## 1 loan_amnt
## 2 funded_amnt
## 3 funded_amnt_inv
## 4 int_rate
## 5 installment
## 6 annual_inc
## 7 dti
## 8 delinq_2yrs
## 9 inq_last_6mths
## 10 mths_since_last_delinq
## 11 mths_since_last_record
## 12 open_acc
## 13 pub_rec
## 14 revol_bal
## 15 revol_util
## 16 total_acc
## 17 out_prncp
## 18 out_prncp_inv
## 19 total_pymnt
## 20 total_pymnt_inv
## 21 total_rec_prncp
## 22 total_rec_int
## 23 total_rec_late_fee
## 24 recoveries
## 25 collection_recovery_fee
## 26 last_pymnt_amnt
## 27 collections_12_mths_ex_med
## 28 mths_since_last_major_derog
## 29 policy_code
## 30 annual_inc_joint
## 31 dti_joint
## 32 acc_now_delinq
## 33 tot_coll_amt
## 34 tot_cur_bal
## 35 open_acc_6m
## 36 open_il_6m
## 37 open_il_12m
## 38 open_il_24m
## 39 mths_since_rcnt_il
## 40 total_bal_il
## 41 il_util
## 42 open_rv_12m
## 43 open_rv_24m
## 44 max_bal_bc
## 45 all_util
## 46 total_rev_hi_lim
## 47 inq_fi
## 48 total_cu_tl
## 49 inq_last_12mComo podemos ver são 49 variáveis numéricas na base de dados e para não alongar ainda mais este texto, vou resumir o trabalho que fiz nos bastidores. Seguindo o exemplo anterior eu separei as variáveis numéricas em dois grupos:
Grupo 1 — Variáveis que mantidas como estão
As variáveis mantidas apresentam valores que podem auxilar o modelo na tarefa de predição.
# number of open credit lines in the borrower's credit file.
# data_cleaned %>% tabyl(open_acc) %>% adorn_pct_formatting() %>% arrange(desc(n))
# number of open trades in last 6 months
# data_cleaned %>% tabyl(open_acc_6m) %>% adorn_pct_formatting() %>% arrange(desc(n))# number of negative public records (like loans that won´t granted)
# data_cleaned %>% tabyl(pub_rec) %>% adorn_pct_formatting() %>% arrange(desc(n))# The number of months since the last public record.
# data_cleaned %>% tabyl(mths_since_last_record) %>% adorn_pct_formatting() %>% arrange(desc(n))# data_cleaned %>% tabyl(mths_since_rcnt_il) %>% adorn_pct_formatting() %>% arrange(desc(n))# data_cleaned %>% tabyl(mths_since_last_major_derog) %>% adorn_pct_formatting() %>% arrange(desc(n))# total collection amounts ever owed
# data_cleaned %>% tabyl(tot_coll_amt) %>% adorn_pct_formatting() %>% arrange(desc(n))# total current balance of all accounts
# data_cleaned %>% tabyl(tot_cur_bal) %>% adorn_pct_formatting() %>% arrange(desc(n))# Total current balance of all installment accounts
# data_cleaned %>% tabyl(total_bal_il) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of finance trades
# data_cleaned %>% tabyl(total_cu_tl) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of collections (recoveries) in 12 months excluding medical collections
# data_cleaned %>% tabyl(collections_12_mths_ex_med) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of currently active installment trades
# data_cleaned %>% tabyl(open_il_6m) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of installment accounts opened in past 12 months
# data_cleaned %>% tabyl(open_il_12m) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of installment accounts opened in past 24 months
# data_cleaned %>% tabyl(open_il_24m) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of revolving trades opened in past 12 months
# data_cleaned %>% tabyl(open_rv_12m) %>% adorn_pct_formatting() %>% arrange(desc(n))# Number of revolving trades opened in past 24 months
# data_cleaned %>% tabyl(open_rv_24m) %>% adorn_pct_formatting() %>% arrange(desc(n))# balance to credit limit on all trades
# data_cleaned %>% tabyl(all_util) %>% adorn_pct_formatting() %>% arrange(desc(n))# The number of accounts on which the borrower is now delinquent.
# data_cleaned %>% tabyl(acc_now_delinq) %>% adorn_pct_formatting() %>% arrange(desc(n))# Ratio of: total current balance to high credit / credit limit on all installment acct
# data_cleaned %>% tabyl(il_util) %>% adorn_pct_formatting() %>% arrange(desc(n))# Maximum current balance owed on all revolving accounts
# data_cleaned %>% tabyl(max_bal_bc) %>% adorn_pct_formatting() %>% arrange(desc(n))Obs: Como estas variáveis podem possuir muitos valores eu as mantive comentadas para evitar processamento e output desnecessários
Para estas variáveis ainda é necessário um segundo passo! Muitas possuem valores em branco o que não é permitido em random forests e por isso é necessário transformar os valores nulos em zero.
data_cleaned =
   data_cleaned %>%
   mutate(
      open_acc = ifelse(is.na(open_acc), 0, open_acc),
      open_acc_6m = ifelse(is.na(open_acc_6m), 0, open_acc_6m),
      pub_rec = ifelse(is.na(pub_rec), 0, pub_rec),
      mths_since_last_record = ifelse(is.na(mths_since_last_record), 0, mths_since_last_record),
      mths_since_rcnt_il = ifelse(is.na(mths_since_rcnt_il), 0, mths_since_rcnt_il),
      mths_since_last_major_derog = ifelse(is.na(mths_since_last_major_derog), 0, mths_since_last_major_derog),
      tot_coll_amt = ifelse(is.na(tot_coll_amt), 0, tot_coll_amt),
      tot_cur_bal = ifelse(is.na(tot_cur_bal), 0, tot_cur_bal),
      total_bal_il = ifelse(is.na(total_bal_il), 0, total_bal_il),
      total_cu_tl = ifelse(is.na(total_cu_tl), 0, total_cu_tl),
      collections_12_mths_ex_med = ifelse(is.na(collections_12_mths_ex_med), 0, collections_12_mths_ex_med),
      open_il_6m = ifelse(is.na(open_il_6m), 0, open_il_6m),
      open_il_12m = ifelse(is.na(open_il_12m), 0, open_il_12m),
      open_il_24m = ifelse(is.na(open_il_24m), 0, open_il_24m),
      open_rv_12m = ifelse(is.na(open_rv_12m), 0, open_rv_12m),
      open_rv_24m = ifelse(is.na(open_rv_24m), 0, open_rv_24m),
      all_util = ifelse(is.na(all_util), 0, all_util),
      acc_now_delinq = ifelse(is.na(acc_now_delinq), 0, acc_now_delinq),
      il_util = ifelse(is.na(il_util), 0, il_util),
      max_bal_bc = ifelse(is.na(max_bal_bc), 0, max_bal_bc)
   )
Grupo 2 — Variáveis que serão removidas
Estas variáveis possuem valores que não contribuem para a análise por serem esparsos ou por se referirem a passos do processo de concessão do empréstimo que não impacta no processo de predição.
# Total revolving high credit/credit limit - could be removed
# data_cleaned %>% tabyl(total_rev_hi_lim) %>% adorn_pct_formatting() %>% arrange(desc(n))
# values received, because this variable is used after the loan aproval, could be removed
# data_cleaned %>% tabyl(total_pymnt) %>% adorn_pct_formatting() %>% arrange(desc(n))
# data_cleaned %>% tabyl(total_pymnt_inv) %>% adorn_pct_formatting() %>% arrange(desc(n))# total interest received, because this variable is used after the loan aproval, could be removed
# data_cleaned %>% tabyl(total_rec_int) %>% adorn_pct_formatting() %>% arrange(desc(n))# Late fees received to date, because this variable is used after the loan aproval, could be removed
# data_cleaned %>% tabyl(total_rec_late_fee) %>% adorn_pct_formatting() %>% arrange(desc(n))# Principal received to date, because this variable is used after the loan aproval, could be removed
# data_cleaned %>% tabyl(total_rec_prncp) %>% adorn_pct_formatting() %>% arrange(desc(n))# Remaining outstanding principal for total amount funded, could be removed
# data_cleaned %>% tabyl(out_prncp) %>% adorn_pct_formatting() %>% arrange(desc(n))# Remaining outstanding principal for portion of total amount funded by investors, could be removed
# data_cleaned %>% tabyl(out_prncp_inv) %>% adorn_pct_formatting() %>% arrange(desc(n))# values charged when the bank recover a loan that whasn´t payed, could be removed
# data_cleaned %>% tabyl(recoveries) %>% adorn_pct_formatting() %>% arrange(desc(n))
# data_cleaned %>% tabyl(collection_recovery_fee) %>% adorn_pct_formatting() %>% arrange(desc(n))# Last total payment amount received, could be removed
# data_cleaned %>% tabyl(last_pymnt_amnt) %>% adorn_pct_formatting() %>% arrange(desc(n))# that variable have the save value for all dataset, could be removed
# data_cleaned %>% tabyl(policy_code) %>% adorn_pct_formatting() %>% arrange(desc(n))# The number of inquiries in past 6 months (excluding auto and mortgage inquiries)
# because are a lack of information about that varible it will be removed
# data_cleaned %>% tabyl(inq_last_6mths) %>% adorn_pct_formatting() %>% arrange(desc(n))
# data_cleaned %>% tabyl(inq_fi) %>% adorn_pct_formatting() %>% arrange(desc(n))
# data_cleaned %>% tabyl(inq_last_12m) %>% adorn_pct_formatting() %>% arrange(desc(n))Obs: Como estas variáveis podem possuir muitos valores eu as mantive comentadas para evitar processamento e output desnecessários
Para fazer a remoção delas utilizei o comando abaixo
data_cleaned =
   data_cleaned %>%
   select(everything(),
          -funded_amnt, -funded_amnt_inv, -installment, -dti, -inq_last_6mths, -mths_since_last_delinq, -total_rev_hi_lim, -total_pymnt, -total_pymnt_inv, -total_rec_int, -total_rec_prncp, -total_rec_late_fee, -total_rec_late_fee, -out_prncp, -out_prncp_inv, -recoveries, -collection_recovery_fee, -dti_joint, -last_pymnt_amnt, -policy_code, -annual_inc_joint, -inq_fi, -inq_last_12m
   ) %>%
   drop_na()
Exploração dos dados
Vamos verificar algumas informações da base final, como a distribuição dos empréstimos de acordo com a variável target:
ggplot(
   data_cleaned %>% group_by(target) %>% summarise(n = n()),
   aes(x = reorder(target, (n)), y = n, fill = target)) +
geom_bar(stat = "identity") +
geom_label(aes(label = n), hjust = 1.2, size = 3) +
scale_colour_viridis_d() +
coord_flip() +
labs(title = 'Volume per loan status', x = "Loan Status", y = "Volume") +
theme(legend.title = element_blank(),
      panel.border = element_rect(NA),
      panel.grid = element_blank(),
      panel.background = element_rect("white"),
      legend.position = "none",
      axis.text.x = element_text(angle = 90),
      strip.background =  element_rect(colour="black", size = 0.5),
      strip.text = element_text(size = 10, color="black", face = "bold"))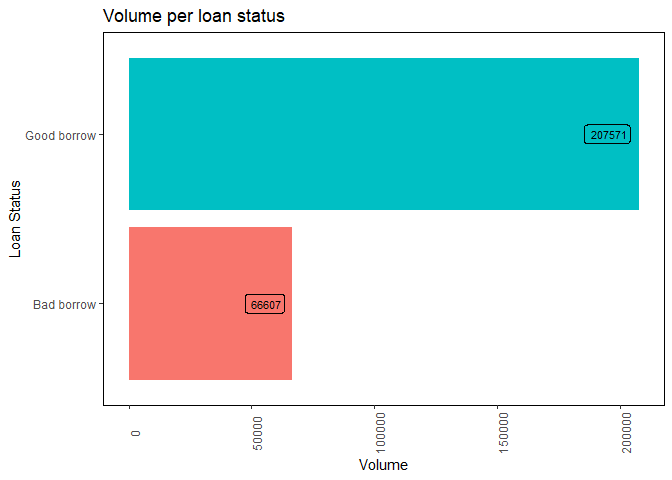
Podemos ver que 66 mil empréstimos (~24% do total) tiveram algum problema com o pagamento.
Dentre as variáveis categóricas preservadas temos a que indica o propósito do empréstimo. Ela pode ajudar a entender quais motivadores são mais propensos a eventuais problemas com pagamento.
ggplot(
   data_cleaned %>%
      group_by(target, purpose) %>%
      summarise(n = n()),
   aes(x = reorder(purpose, (n)), y = n, fill = target)) +
   geom_bar(stat = "identity") +
   geom_label(aes(label = n), hjust = 1.2, size = 3) +
   scale_colour_viridis_d() +
   coord_flip() +
   labs(title = 'Loans per purpose', x = "Purpose", y = "Volume") +
   theme(legend.title = element_blank(),
         panel.border = element_rect(NA),
         panel.grid = element_blank(),
         panel.background = element_rect("white"),
         legend.position = "none",
         axis.text.x = element_text(angle = 90),
         strip.background =  element_rect(colour="black", size = 0.5),
         strip.text = element_text(size = 10, color="black", face = "bold"))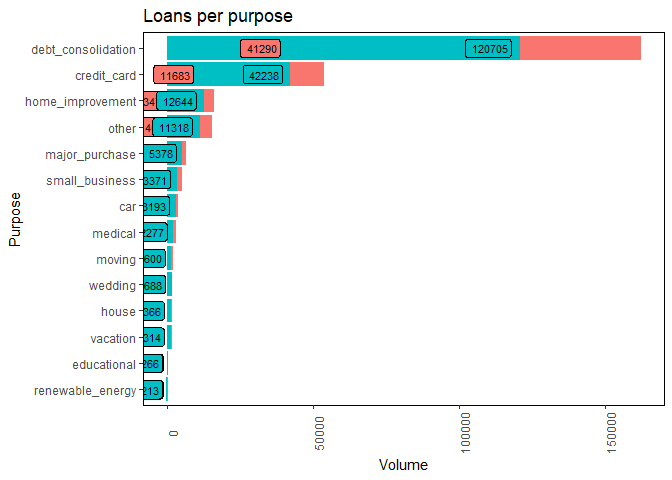
Como podemos observar, empréstimos com o propósito debt_consolidation apresenta a maior incidência de empréstimos com problemas de pagamento.
Preparação dos dados para o modelo
Uma vez que os dados foram tratados e “limpos” podemos prepará-los para executarmos nossa random forest. Este passo embora simples, é fundamental para continuarmos. Ele pode ser separado em 3 etapas:
- Separação dos dados de treino e teste: para isso eu utilizei o comando sample.split do pacote caTools. Ele irá criar uma lista de valores booleanos para cada empréstimo de nossa base. Aleatoriamente irá indicar qual será deles será utilizado em nossa base de treino, que terá 80% dos dados. Ela irá utilizar como base a coluna target, para garantir que tenha uma distribuição uniforme para teste e treino
- Criação da base de treino: utilizando a lista criada anteriormente faremos uma cópia dos dados de treino para um dataset separado
- Criação da base de teste: esta base será utilizada para validar o modelo que criamos
train_sample = caTools::sample.split(
   data_cleaned$target,
   SplitRatio = .80)
train_data = subset(data_cleaned, train_sample == T)
test_data = subset(data_cleaned, train_sample == F)O próximo passo é avaliar a base de dados para identifica quais são os melhores parâmetros para nosso modelo. Para isso utilizei o comando tuneRF do pacote randonForests. Ele irá avaliar a taxa de acerto de diferentes combinações das variáveis de nossa base até encontrar aquela que apresenta a melhor taxa.
mtry =
   randomForest::tuneRF(
      #list of variables that will be used, in this case all but target
      train_data %>% select(-target),
      # the information that we want to predict
      train_data$targe,
      # number of trees that should be evaluated
      ntreeTry=300,
      stepFactor=1.5,
      improve=0.01)
## mtry = 5 OOB error = 23.89%
## Searching left ...
## mtry = 4 OOB error = 23.97%
## -0.003454528 0.01
## Searching right ...
## mtry = 7 OOB error = 23.93%
## -0.001698635 0.01Agora podemos iniciar a execução de nosso modelo. Não vou entrar em detalhes aqui sobre random forests, por isso deixo o link para um outro texto que escrevi sobre o tema e falo com um pouco mais de detalhes no Blog Medium
model =
   randomForest::randomForest(
      # a fórmula da árvore, a informação de ataque cardíaco (stroke) em função de todas as variáveis de nossa base de dados
      formula = target ~ .,
      # a base de treino com xxxx registros
      data = train_data,
      # quantidade de colunas que serão utilizadas em cada árvore
      mtry = 5,
      # quantidade de árvores que devem ser criadas pelo algorítmo
      ntree=300)
Vamos verificar quais foram as variáveis que geraram a menor quantidade de erros durante a execução do modelo.
randomForest::varImpPlot(model, sort = T, )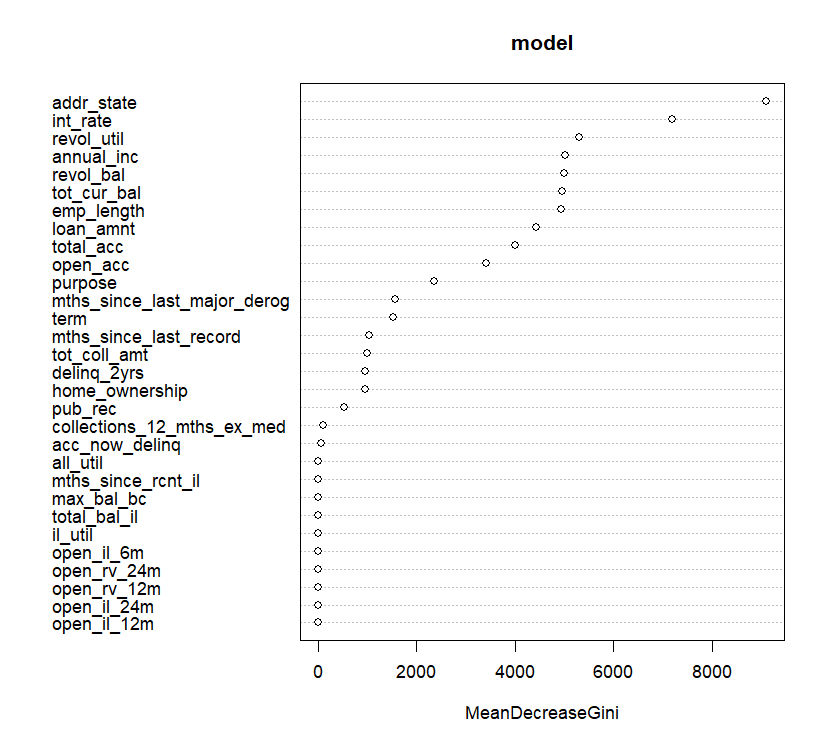
Podemos ver que as variáveis addr_state e int_rate foram as mais relevantes, enquanto open_li_24 e open_li_12 não geraram impacto sobre o resultado.
Conferindo o resultado
O próximo passo agora é adicionar em nossa base de teste uma coluna com o resultado predito pelo nosso modelo, para que possamos compará-la com o resultado real.
test_data$rf_prediction =
    predict(model, test_data, type = “class”)
Vamos criar uma matriz de confusão para visualizarmos o resultado predito
confusion_table =
   as.data.frame(
      table(
         real = test_data$loan_status,
         predicted = test_data$rf_prediction)
   ) %>%
   mutate(`*` = ifelse(real == predicted, '*', '')) %>%
   left_join(test_data %>%
                group_by(real = loan_status) %>%
                summarise(n_real = n()), by="real") %>%
   arrange(real)
Agora vejamos o resultado:
confusion_table %>%
   filter(`*` == '*') %>%
   mutate(acuracy = ifelse(
      Freq == 0,
      0,
      round((Freq / n_real) * 100, 2))) %>%
   select(real, Freq, n_real, acuracy)
real Freq n_real acuracy
1 Bad borrow 675 13321 5.07
2 Good borrow 41074 41514 98.94Vamos conferir a acurácia do modelo, ou seja, o percentual geral de acerto:
confusion_table %>%
   mutate(correct_prediction = ifelse(
      real == predicted,
      Freq,
      0)) %>%
   summarise(total = sum(Freq),
             correct = sum(correct_prediction)) %>%
   mutate(acuracy = correct / total)
#  total  correct   accuracy
#1 54835    41749  0.7613568
Combinando as duas informações podemos ver que de forma geral o modelo foi capaz de acertar 76% dos 54 mil empréstimos, porém ele erra mais ao tentar prever maus pagadores, apenas 5% dos empréstimos foram indicados corretamente. Já na previsão de bons pagadores, o modelo foi capaz de acertar ~99% de todos os empréstimos!
Conclusões
Vimos que o modelo possui uma acurácia interessante, sendo muito bom em dizer se a pessoa irá pagar o empréstimo até o final, mas apresenta algumas falhas ao prever aqueles que não irão pagá-lo.
Para encerrar, o que eu acho bacana em data science é que ela não se trata apenas de criar modelos matemáticos, existe um universo inteiro de análise de dados e compreensão do problema que se deseja resolver. Por exemplo neste caso, eu poderia chegar à conclusão de que uma regressão logística seria suficiente para resolver esta necessidade de prever se aquela pessoa irá ou não pagar seu empréstimo até o final.
Caso encontre alguma canelada ou um falha no código por favor entre em cotnato comigo através do e-mail marcosmhs@live.com e ficarei feliz em fazer os ajustes necessários e colocá-lo(a) como co-autor.