Investir seu rico dinheirinho é um assunto delicado, muitos tem medo de perder outros tem medo de não ganhar. Como eu me encaixo nestes dois cenários e por ter a terrível mania de investir na alta e vender na baixa, perdendo sempre tento recorrer aos números como forma de evitar perder o pouco que sobrou.
Brincadeiras à parte tenho consegui algum sucesso observando alguns investidores e olhando para indicadores que ajudam a determinar se um papel vai ou não dar retorno.
Encontrei recentemente um script que listava os fundos imobiliários com pagamento de dividendos e aproveitei para expandir seu uso para me ajudar a encontrar aqueles que fazem mais sentido investir.
Vamos ao código!
import pandas as pd
import requests
import webbrowser
from ipywidgets import interact, interact_manual
Os dados virão do site www.fundsexplorer.com.br, para isso usei o pacote request para acessar o ranking de fundos disponíveis
pd.options.display.float_format = '{:.2f}'.format
page_data = requests.get("https://www.fundsexplorer.com.br/ranking").text
Uma vez obtido os dados do site foi necessário transformá-los em um dataframe e fazer algumas conversões.
df_fiis = pd.read_html(page_data)[0]

# remove os caracteres que irão impedir conversão de dados
df_fiis = df_fiis.replace(["R\$", "%", "\."], "", regex = True)

# substitui , por . (para permitir a transformação do string em float)
df_fiis = df_fiis.replace(",", ".", regex = True)

# valor do P/VPA muda durante a importacão, isso é necessário para retorná-lo ao valor original
df_fiis["P/VPA"] = df_fiis["P/VPA"] / 100
df_fiis["VPA"] = pd.to_numeric(df_fiis["VPA"], downcast="float") / 100
Visualizando os dados vemos que temos 25 colunas com os dados necessários para nossa análise. No código fonte eu detalho um pouco mais algumas delas.
df_fiis.head()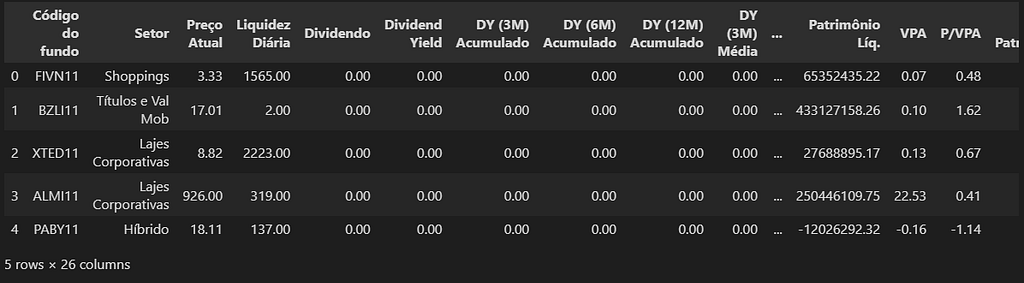
Neste exemplo eu vou analisar todas os fundos disponíveis até e no futuro manterei apenas aqueles que tenho maior interesse em investir. Para isso eu criei a lista fii_list com o código de todos os fundos.
fii_list = df_fiis['Código do fundo'].unique().tolist()Na sequência eu calculei a nota de todos os fundos multiplicando o:
o Indicador calculado pela divisão do preço da cota sobre o valor do patrimonial do fundo pela Média do Dividend Yield no último ano
Desta forma é possível identificar os fundos que podem gerar maior retorno neste período
filtered_fiis = df_fiis[df_fiis["Código do fundo"].isin(fii_list)]
analized_fiis = filtered_fiis[["Código do fundo", "Setor", "Preço Atual", "Dividend Yield", "DY (3M) Média", "DY (6M) Média", "DY (12M) Média", "VPA", "P/VPA"]]

analized_fiis['Nota'] = (
                                (1 / analized_fiis['P/VPA'])
                                * pd.to_numeric(df_fiis["DY (12M) Acumulado"], downcast="float")
                           )

analized_fiis.sort_values(by=["Nota"], inplace=True, ascending=[False])
Ao final teremos o dataframe analized_fiis com o resultado de nossa análise, classificados da maior nota (melhor) para a menor (pior)
analized_fiis.nlargest(10, 'Nota')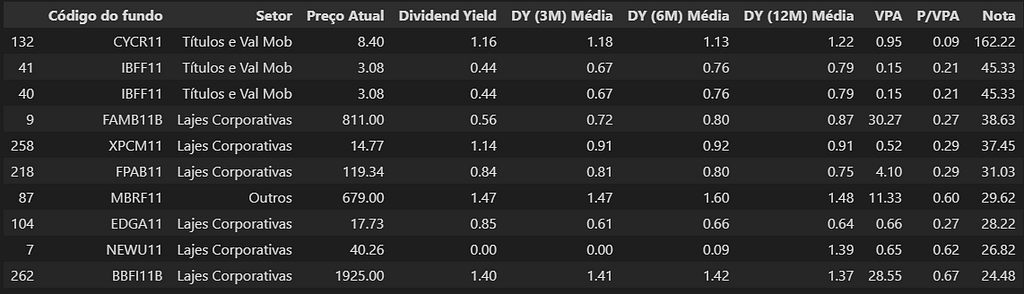
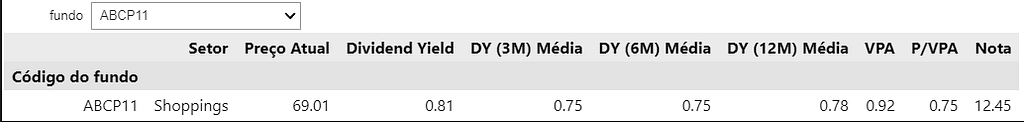
Para ajudar em minha análise também criei uma função que retorna um determinado fundo e abre o site fundsexplorer com os detalhes
def list_fii_data(fundo):
    webbrowser.open_new('https://www.fundsexplorer.com.br/funds/' + fundo)
    return analized_fiis.set_index('Código do fundo').loc[[fundo]]

interact(
    list_fii_data,
    fundo= analized_fiis.sort_values(by=["Código do fundo"])['Código do fundo'].unique(). tolist()

)
O código fonte pode ser acessado em meu github!
Caso encontre algum erro ou câimbra mental me avise no marcosmhs@live.com e ficarei feliz em fazer os ajustes garantindo o devido crédito à sua contribuição. :)