Imagine que você criou uma carteira de investimentos, com ações de empresas que você conhece e acredita que pode gerar bons resultados e estão alinhadas com seus critérios de ESG e governança. Vamos supor que você selecionou 6 empresas e possui R$ 60.000 para iniciar sua carteira. Se você preparou 6 cheques de R$ 10.000 para enviar para o escritório de cada uma eu tenho 2 más notícias… A primeira é que não é assim que se compra ações e a segunda é que você pode estar fazendo um mal negócio.
Isso porque empresas diferentes possuem rendimentos diferentes e se o objetivo aqui é garantir um bom rendimento é necessário pensar em como maximizar seus lucros.
Foi isso o que pensou Willian Sharpe em 1966 quando criou um índice para ajudar a encontrar o percentual de investimento em cada item de sua carteira afim de maximizar o retorno com o menor risco possível utilizando apenas os dados históricos das ações. Este índice recebeu o nome de Sharpe Ratio!
Bora lá entender como calcular este negócio, usando o Python!
Como sempre vamos preparar nosso ambiente com as bibliotecas necessárias
import yfinance as yf
import datetime
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

from scipy.optimize import minimize
from pandas_datareader import data as web

# definição do período de seleção dos dados históricos das ações analisadas
start date = datetime.datetime(2022,1,1)
end_date = datetime.datetime(2022,11,30)
Em seguida vamos selecionar as 6 ações de nossa carteira fictícia, neste caso:
- Gerdau (GGBR4.SA) — Produtora de aço
- Copel (CPLE6.SA) — Companhia de fornecimento de energia Paranaense
- Assaí (ASAI3.SA) — Atacadista
- Itaú (ITUB4.SA) — Banco
- Natura (NTCO3.SA) — Produtos de beleza
- Vale (VALE3.SA) — Mineradora
# houve uma alteração no retorno do yahoo finance e esta linha é
# necessária até que o Pandas DataReader seja corrigido.
yf.pdr_override()
#Gerdau
goau = web.get_data_yahoo(['GOAU4.SA'], start = start_date, end=end_date)
#Copel
cple = web.get_data_yahoo(['CPLE6.SA'], start = start_date, end = end_date)
# Assaí
asai = web.get_data_yahoo(['ASAI3.SA'], start = start_date, end = end_date)
#Itaú
itub = web.get_data_yahoo(['ITUB4.SA'], start = start_date, end = end_date)
#Natura
ntco = web.get_data_yahoo(['NTCO3.SA'], start = start_date, end = end_date)
#Vale
vale = web.get_data_yahoo(['VALE3.SA'], start = start_date, end = end_date)
# lista com os nomes das ações
stocks_names = ['Gerdau', 'Copel', 'Assaí', 'Itaú', 'Natura', 'Vale']
Vamos utilizar o código abaixo para ter uma noção do desempenho de cada uma:
fig = plt.figure(figsize = (20,8))
gs = fig.add_gridspec(2, 3, wspace = 0)
(ax1, ax2, ax3), (ax4, ax5, ax6) = gs.subplots()

ax1.plot(goau['Close'])
ax1.set_title(stocks_names[0])
ax2.plot(cple['Close'], )
ax2.set_title(stocks_names[1])
ax3.plot(asai['Close'], 'tab:green')
ax3.set_title(stocks_names[2])
ax4.plot(itub['Close'], 'tab:red')
ax4.set_title(stocks_names[3])
ax5.plot(ntco['Close'], 'tab:blue')
ax5.set_title(stocks_names[4])
ax6.plot(vale['Close'], 'tab:gray')
ax6.set_title(stocks_names[5])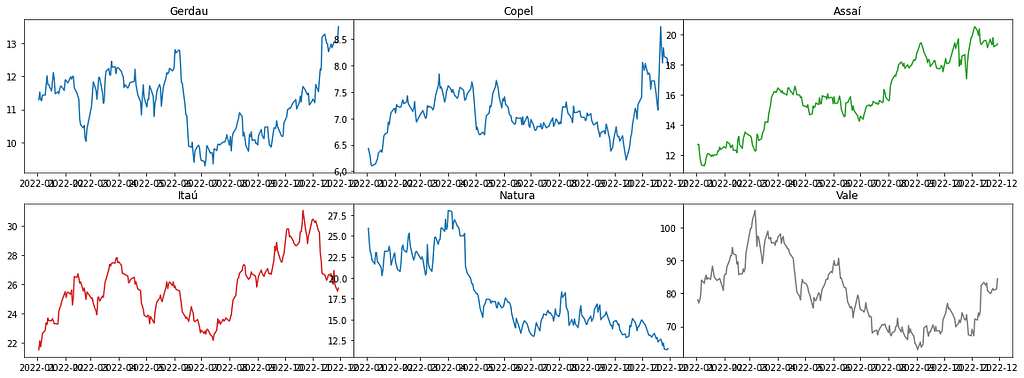
Podemos ver que a Gerdau, Copel e Assaí apresentam padrões de crescimento interessantes, enquanto Natura, Itaú e Vale trazem queda ou crescimento tímido
Como os dados estão separados em 6 dataframes diferentes precisamos uni-los em um só local e nesta união utilizaremos apenas a coluna Close, que armazena o valor do fechamento da ação em um dia
# com o concat será feita a união dos dataframes. A opção axis indica que queremos os dados sejam colocados em colunas diferentes ao invés de concatenar as linhas
stocks = pd.concat([
    goau['Close'],
    cple['Close'],
    asai['Close'],
    itub['Close'],
    ntco['Close'],
    vale['Close']
    ],axis= 1)
# agora renomeamos as colunas para que tenham o nome de suas respectivas ações
stocks.columns = stocks_names

stocks. Head(5)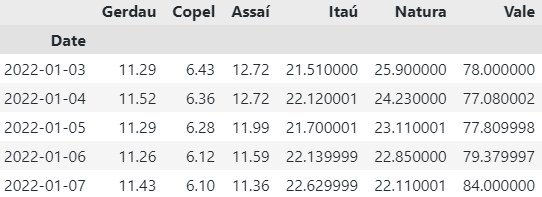
Agora vamos preparar os dados para a análise, começando pela criação de uma matriz com o retorno de cada ação por data, seguindo a fórmula:
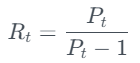
Onde:
- R é o retorno
- P é o preço
- P-1 é o preço na data anterior
Todos os elementos são subscritos (t), ou seja, todos são em função do tempo.
# neste caso o shift faz o LAG do valor, ou seja, pega o valor correspondente ao dia anterior
returns = stocks / stocks.shift(1)
# vemos que os primeiros valores são inválidos pois não há uma data anterior para o cálculo
returns. Head(5)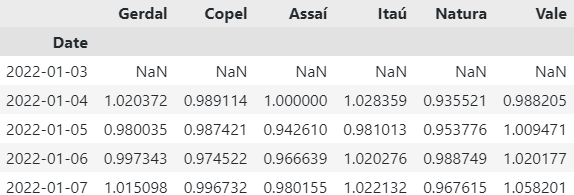
Em seguida faremos a padronização dos valores:
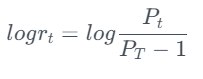
Mas não se preocupe porque no Python isso é muito fácil:
log_returns = np.log(returns)
log_returns.head(5)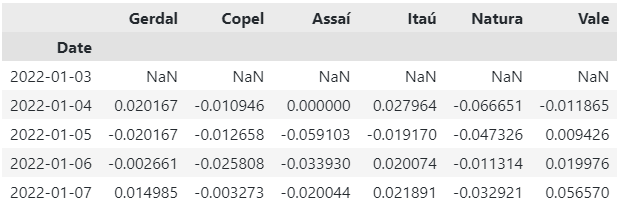
Podemos ver que os valores, que antes oscilavam entre R$ 6 (Copel) e R$ 71(Vale), agora oscilam entre -1 e 1
Calculando o Sharpe Ratio
Como dito anteriormente, este índice considera o retorno de acordo com o risco envolvido, utilizando dados históricos. Abrindo um pouco a caixa do método, temos a fórmula:
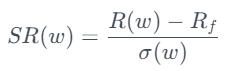
Onde
- SR é o Sharpe Ratio, o valor que desejamos obter
- (w) é o peso de cada ação. Neste caso o valor normalizado de todos os valores de nossa lista, ou seja, ao somar todos os valores teremos 1 como resultado. Esse valor irá ajudar a definir o percentual de nosso investimento em cada ação. Neste exemplo, w1 é Gerdau, w2 é Copel e assim por diante
- R(f) é o retorno caso não exista risco, e como veremos mais adiante é um valor desprezado, não precisaremos dele.
- Sigma é desvio padrão ou volatilidade
w é a soma dos pesos dentro de um determinado dia
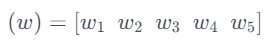
R(w) é retorno do investimento: matriz transposta dos pesos multiplicado pelo valor do dia anterior (log)
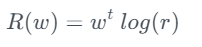
sigma(w) — risco do investimento é a raiz da matriz transposta de pesos multiplicado pela soma dos pesos
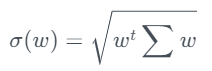
Ao final teremos a fórmula que será utilizada:
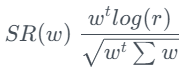
Agora sim, vamos ao cálculo do retorno vs volatilidade, neste caso avaliaremos 10.000 portfólios diferentes, gerando peso aleatórios para cada uma das ações
number_of_portfolios = 10000
number_of_stocks = len(stocks.columns)

# vamos criar os vetores que serão utilizados e iniciá-los com zero
weights = np.zeros((number_of_portfolios, number_of_stocks))
expected_return = np.zeros(number_of_portfolios)
expected_volatility = np.zeros(number_of_portfolios)
sharpe_ratio = np.zeros(number_of_portfolios)

# Como utilizaremos a média dos retornos padronizados (log_returns),
# vamos calculá-la agora para evitar processamento excessivo durante o loop
mean_log_returns = log_returns.mean()

# utilizaremos a matriz de covariância (grau de interdependência)
# entre as ações de nossa base
sigma = log_returns.cov()

# vamos correr todo o portfólio, quanto maior o número de
# iterações maior a quantidade combinações a serem feitas
for i in range(number_of_portfolios):

    # (w)
    # criar vetor com pesos aleatórios, usado em cada uma das iterações
    w = np.array(np.random.random(number_of_stocks))
    # encontra o percentual de cada peso gerado anteriormente
    w = w / np.sum(w)

    # salva o valor dentro da matriz
    weights[i,:] = w

    # R(w)
    # calcular o log return multiplicando o valor com LAG pelo peso.
    # Esta matriz terá apenas uma coluna, com o retorno esperado para
    # aquele dia de todas as ações da carteira
    expected_return[i] = np.sum(mean_log_returns * w)

    # sigma(w)
    expected_volatility[i] = np.sqrt(
        np.dot(
            w.T,
            np.dot(sigma, w)
        )
    )

    # Sharpe ratio, o retorno dividido pela volatilidade
    sharpe_ratio[i] = expected_return[i] / expected_volatility[i]
Uma vez calculado o Sharpe ratio para todos os portfólios vamos verificar o melhor índice, aquele com maior retorno.
# retorna a posição que garante o maior retorno nas ações
# de acordo com o sharpe ratio
max_index = sharpe_ratio.argmax()

# agora podemos ver qual o percentual de nosso orçamento que
# podemos alocar em cada uma das ações para maximizar nosso retorno.
weights[max_index, :]
Para melhorar a visualização dos dados podemos criar um gráfico de barras, com o código abaixo
plt.figure(figsize=(16,5))
hbars = plt.bar(
    x = stocks_names,
    height=weights[max_index, :] * 100
)
plt.bar_label(hbars, fmt='%.2f')
plt.ylabel('% de Investimento')
plt.title('Distribuição do investimento no portfólio selecionado')
plt.show()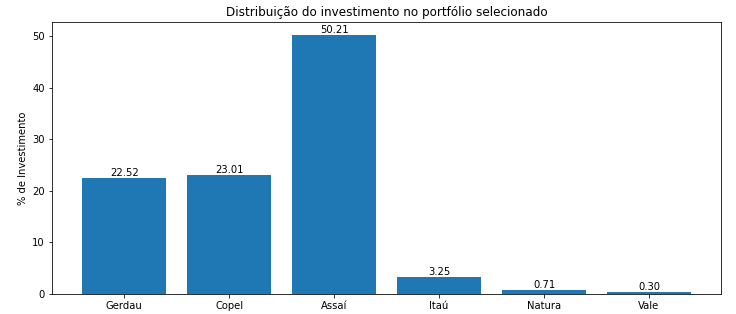
Segundo o Sharpe Ratio devemos investir 50% de nosso orçamento em ações do Assaí (ASAI) e menos de 1% nas ações da Vale (VALE).
O interessante deste modelo é que ele pode ser aplica à praticamente qualquer carteira, desde que se tenha dados históricos em um mesmo período de todas as ações dela
Vamos visualizar os, dentro de todo o portifólio criado onde está o nosso ponto que maximiza o Sharpe Ratio
plt.figure(figsize = (16,8))
# plota a volatilidade e o retorno classificado de acordo
# com o maior valor do Sharpe Ratio
plt.scatter(
    expected_volatility,
    expected_return,
    c=sharpe_ratio
)
plt.xlabel('Volatilidade esperada')
plt.ylabel('Retorno Esperado')
plt.title('Comparação entre portfólio')
plt.colorbar(label = 'SR', extend = 'max')
# plota em vermelho o max_index, ou seja, o ponto de maior
# retorno e menor risco
plt.scatter(
    expected_volatility[max_index],
    expected_return[max_index],
    c='red',
    s=70,
)
plt.show()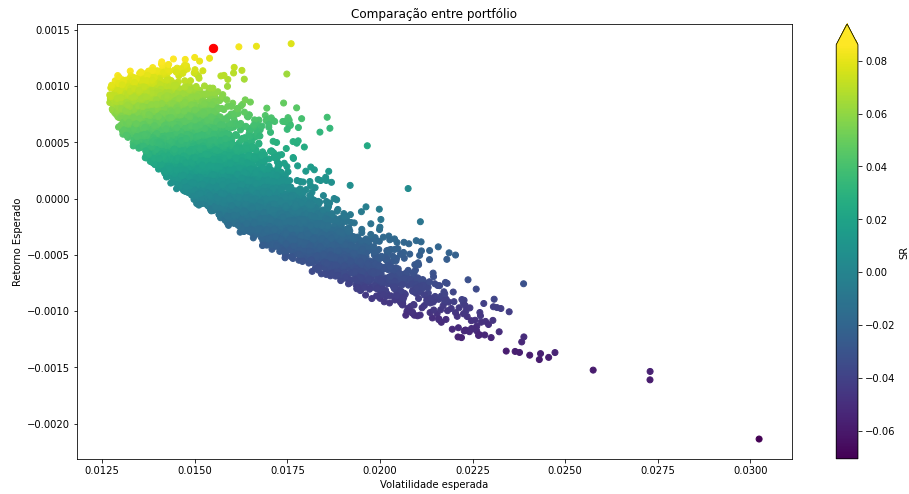
Podemos observar no gráfico acima que os maiores retornos (em amarelo) estão no limite superior de nossa amostra, e cabe ao investidor avaliar o risco (eixo X) que deseja correr para alcançar aquele retorno.
O ponto vermelho indica o maior retorno que podemos ter com o menor risco possível.
Bacana, não é?
Como o objetivo deste texto não é ajudar na previsão de receita e sim ajudar a definir o valor de investimento baseado em dados históricos, deixo aqui o link de um texto (em inglês) que escrevi sobre o uso de uma rede neural LSTM para a predição do valor de ações, aqui mesmo no Medium.
Caso tenha encontrado alguma “câimbra mental” ou mesmo um erro de código por favor me avise através do e-mail marcosmhs@live.com e eu ficarei feliz em corrigir o texto e creditá-lo.
Como sempre o código completo pode ser encontrado em meu GitHub